robots.txtの書き方|ECサイトでクロールを制御する際の注意点
目次
robots.txtは、検索エンジンのクローラーに対して、サイト内のどのURLを取得してよいかを伝えるファイルです。ECサイトでは、管理画面や不要な検索URLなどへのクロールを抑える目的で使えます。
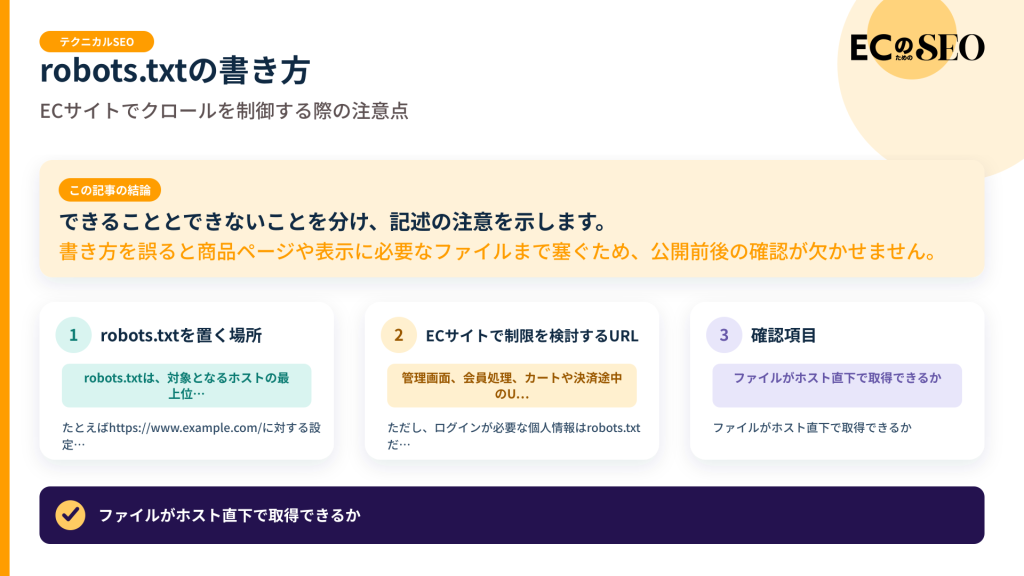
一方、robots.txtは検索結果からページを確実に消すための設定ではありません。noindexやcanonicalとも役割が異なります。書き方を誤ると商品ページや表示に必要なファイルまで塞ぐため、公開前後の確認が欠かせません。
robots.txtを置く場所
robots.txtは、対象となるホストの最上位に置きます。たとえばhttps://www.example.com/に対する設定は、https://www.example.com/robots.txtで公開します。サブドメインは別のホストとして、それぞれ確認が必要です。
ファイルが見つからない状態と、すべて許可する記述は結果が近い場合がありますが、運用上は意図が分かる設定を用意します。ステージング環境のrobots.txtが本番へ混ざらないよう、配信環境ごとの管理も必要です。
基本の記述
User-agentで対象クローラーを指定し、Disallowで取得を制限するパスを示します。すべてのクローラーを対象にする場合はアスタリスクを使います。Allowは、広く制限したパスの一部を許可したいときに使えます。
記述はURLのパターンへ作用します。管理画面のディレクトリを制限するつもりが、同じ文字列を含む商品URLにも一致することがあるため、実在URLの一覧でテストします。
robots.txtでできること
主な用途は、クローラーのアクセスを管理し、サーバー負荷や不要URLへの取得を抑えることです。カート処理、管理機能、無限に生成される一部の操作用URLなどが候補になります。
ただし、クロールを制限すべきかはサイト構造によって異なります。URLそのものの生成や内部リンクを止められるなら、そのほうが根本的な解決になる場合があります。
robots.txtでできないこと
robots.txtでDisallowしたURLでも、外部リンクなどからURL自体が知られていれば、内容を取得しないまま検索結果に現れる可能性があります。検索結果から除外したいページには、クロールを許可した状態でnoindexを読み取らせるなど、目的に合う方法を使います。
また、重複URLの正規化にはcanonicalや転送を使います。robots.txtをcanonicalの代わりに使うと、ページ内容やcanonical指定を確認できなくなります。
ECサイトで制限を検討するURL
管理画面、会員処理、カートや決済途中のURL、無限に生成される一部のサイト内検索やパラメータURLなどが候補です。ただし、ログインが必要な個人情報はrobots.txtだけで保護せず、認証でアクセスを制限します。
絞り込みURLは、検索対象にする組み合わせと操作用の組み合わせが混在します。ディレクトリ単位で一律に塞ぐ前に、価値のある着地ページまで対象にならないかを確認します。
CSSやJavaScriptを安易にブロックしない
Googleはページを理解する際に、CSSやJavaScriptを使ってレンダリングすることがあります。表示に必要なリソースを制限すると、商品情報、モバイル表示、リンクが正しく把握されない可能性があります。
古い設定に、画像やスクリプトのディレクトリをまとめてDisallowする記述が残っていないか確認します。機密情報は公開ディレクトリへ置かず、認証やサーバー設定で保護します。
noindexとの組み合わせに注意する
noindexはページを取得したクローラーが読み取る設定です。robots.txtで同じURLをブロックすると、Googleがnoindexを確認できない場合があります。すでに登録されたURLを除外したいときは、クロールを許可してnoindexを読ませる必要があります。
除外を確認した後にクロール制限を追加する運用もありますが、将来設定を変えた際の再登録や他クローラーの挙動も考え、URL種別ごとの方針を文書化します。
Sitemapの場所を伝える
robots.txtにはSitemapの行を記述し、XMLサイトマップのURLを知らせられます。サイトマップはクロール許可の代わりではなく、検索対象にしたい正規URLを伝える補助手段です。
複数のサイトマップやサイトマップインデックスがある場合も指定できます。記述したURLが実際に200で取得でき、Search Consoleへ登録したものと一致するかを確認します。
変更前後の確認手順
現在のrobots.txtを保存し、変更する行、対象URL、目的を記録します。重要商品、カテゴリ、画像、CSS、JavaScript、制限対象URLのサンプルを用意し、それぞれの一致結果を確認します。
公開後はrobots.txt自体が200で取得できるか、意図しない全体ブロックがないかを確認します。Search ConsoleのURL検査やサーバーログも使い、主要ページが引き続きクロールされているかを見ます。
よくある間違い
- Disallowすれば検索結果から必ず消えると考える
- noindexを設定したページも同時にブロックする
- CSSやJavaScriptのフォルダを一括で制限する
- テスト環境の全体ブロックを本番へ持ち込む
- ワイルドカードの一致範囲を確認しない
確認項目
- ファイルがホスト直下で取得できるか
- 主要商品とカテゴリが許可されているか
- 必要な画像、CSS、JavaScriptを塞いでいないか
- noindexやcanonicalの目的と混同していないか
- サイトマップURLが正しいか
- 変更履歴と担当者が残っているか
ECサイト向けの記述例を考える
たとえば管理画面が「/admin/」配下にあり、公開ページとは完全に分かれているなら、そのパスを制限する方針を検討できます。一方「/search/」配下にサイト内検索と検索対象にしたい固定特集が混在するなら、ディレクトリ全体のDisallowは危険です。
実際の記述はサイトのURL構造に依存します。一般的なサンプルをそのまま貼らず、制限対象と許可対象の実在URLを最低でも数件ずつ用意します。クエリパラメータを対象にする場合も、順序違いや類似名への一致を確認します。
障害時のrobots.txtの挙動を知る
robots.txt自体が長期間取得できないと、クロールへ広い影響が出ます。CDN、WAF、デプロイ設定でrobots.txtだけが403や5xxにならないように監視します。HTMLページが正常でも、制御ファイルの障害は別に起こり得ます。
ファイルを動的生成する場合は、商品データベース障害に巻き込まれない構成を検討します。頻繁な書き換えを避け、変更時には構文と対象URLのテストを自動化します。
変更権限とレビューを管理する
robots.txtは一行の変更がサイト全体へ及ぶことがあります。誰でも直接編集できる状態にせず、変更理由、対象クローラー、対象URL、公開日時、戻し方をレビューします。
大型リニューアルでは、旧環境、新環境、ステージング、本番のファイルを並べて確認します。公開直後のチェックリストへrobots.txtの取得と主要URLの許可状態を入れ、検索流入の変化を待たずに誤設定を発見します。
公開前のテストケース
許可するURLには、トップ、商品、カテゴリ、画像、CSS、JavaScript、サイトマップを含めます。制限するURLには、管理画面、カート処理、無限生成される検索条件などを含めます。各URLがどのルールに一致するかを確認します。
URLの大文字・小文字、末尾スラッシュ、クエリの順序も試します。ワイルドカードや末尾指定を使う場合は、似た商品コードやカテゴリ名を誤って含まないかを重点的に見ます。
公開後はrobots.txtを別のネットワークから取得し、キャッシュされた旧ファイルでないことを確認します。主要URLのURL検査とログを見て、Googlebotが実際に取得できているところまで確認して完了とします。
まとめ
robots.txtは、クローラーが取得できるURLを管理するためのファイルです。検索結果からの除外や重複URLの正規化を直接行うものではありません。
ECサイトでは、制限対象だけでなく、商品ページ、画像、CSS、JavaScriptが許可されているかを必ず確認してください。URL例と目的を記録し、小さな変更単位で公開すると、全体への誤設定を防ぎやすくなります。