Googleのクロールとは?ECサイトのページが発見される仕組み
目次
Googleのクロールとは、Googlebotと呼ばれるクローラーがURLを発見し、ページのHTMLや画像などを取得する過程です。ECサイトで新商品を公開しても、URLが発見され、取得できなければ内容を評価する段階へ進みません。
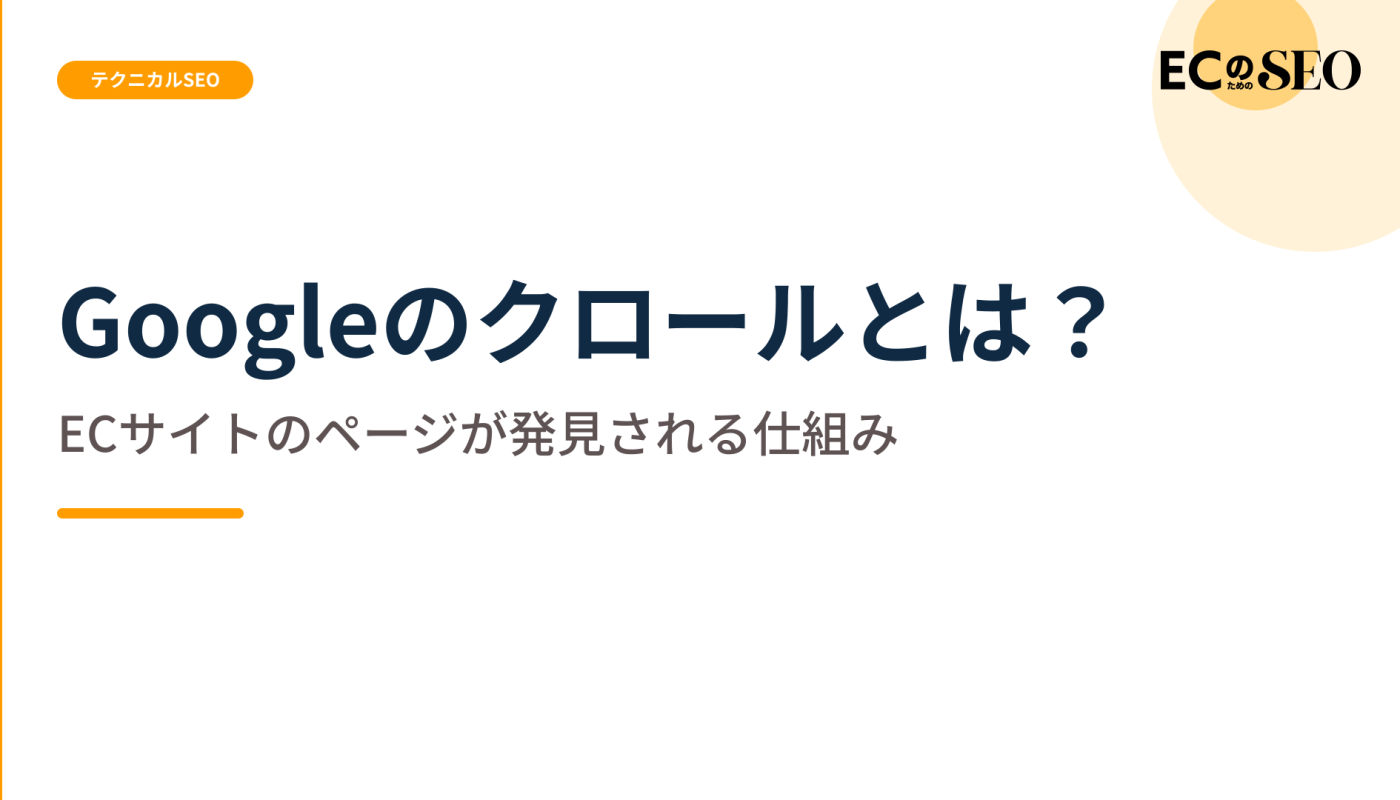
ただし、クロール回数を増やすこと自体が目的ではありません。検索対象にしたい商品やカテゴリへ分かりやすい経路を用意し、不要な操作用URLへクロールが偏らない状態を作ることが重要です。
GoogleがURLを見つける主な経路
Googleは、すでに知っているページ内のリンク、XMLサイトマップ、過去に取得したURL、外部サイトのリンクなどから新しいURLを見つけます。ECサイトでは、カテゴリページの商品カードや新着商品一覧が代表的な発見経路です。
商品を管理画面へ登録しただけでは、公開サイト上のリンクが作られていないことがあります。サイトマップに載せるだけでなく、利用者もたどれるカテゴリや特集からリンクすることが基本です。
クロールとインデックスの違い
クロールはページを取得する段階で、インデックスは取得した内容を分析して検索用のデータベースへ登録する段階です。クロール済みでも、重複、noindex、内容不足などにより登録されない場合があります。
Search ConsoleのURL検査では、最終クロール日時や取得状況を確認できます。「クロール済みなのに検索に出ない」場合は、クロール回数を増やす前にインデックス上の理由を調べます。
リンクはhrefを持つ形で用意する
Googleは一般に、a要素のhref属性にあるURLをリンクとしてたどります。商品カード全体をJavaScriptのクリック処理だけで遷移させる実装では、URLが発見されにくくなる可能性があります。
商品名や画像に通常のリンクを設定し、ログインやボタン操作なしで商品詳細へ移動できるようにします。「もっと見る」や無限スクロールを使う場合も、後半の商品へページ単位のURLとリンクを用意します。
robots.txtがクロールへ与える影響
robots.txtは、クローラーに取得を許可するURLと制限するURLを伝えるファイルです。管理画面や無限に生成される不要なURLへのアクセスを抑える目的で使えますが、検索結果から確実に消す仕組みではありません。
また、noindexを読み取ってほしいページをrobots.txtでブロックすると、Googleがページ内のnoindexを確認できません。CSSやJavaScriptを広くブロックすると、表示内容を正しくレンダリングできない場合もあります。
ECサイトでクロールが分散する原因
色、サイズ、価格帯、並び順、表示件数、計測パラメータなどを自由に組み合わせると、似た内容のURLが大量にできます。セッションIDや時刻を含むURLが内部リンクに混ざる場合もあります。
クローラーはURLごとに取得するため、同じ商品集合を返すURLでも別URLとして処理されます。生成を止める、内部リンクを正規URLへ統一する、canonicalを整えるなど、原因に応じた対応が必要です。
新商品を発見しやすくする方法
新商品は、既存の主要カテゴリから通常リンクで到達できる状態にします。公開直後だけ新着一覧へ載せ、その後どこからもリンクされなくなる設計では、継続的な発見経路が弱くなります。
XMLサイトマップは公開状態の商品だけを自動出力し、更新日時を正確に管理します。少数の重要URLならSearch ConsoleのURL検査を補助的に使えますが、大量商品を一件ずつ申請する運用には向きません。
サーバーの状態もクロールに影響する
サーバーが遅い、5xxエラーや429が多いといった状態では、Googleのクローラーが一時的に取得を控えることがあります。セール開始時や商品データ一括更新時は、人のアクセスだけでなくクローラーのリクエストも考慮します。
障害時にすべてのURLへ200とエラーメッセージを返すと、正常ページと区別できません。利用できない状態に応じたHTTPステータスを返し、復旧後は主要URLの応答とログを確認します。
クロール状況を確認する方法
Search ConsoleのURL検査では個別ページを、クロールの統計情報ではGooglebotのリクエスト傾向を確認できます。サーバーログが使える場合は、どのURL群に何回アクセスしているか、エラーや応答時間がどうなっているかも調べられます。
ログを分析するときは、リクエスト数だけでなくURLの種類で分けます。重要商品へのクロールが少なく、並び替えや検索結果URLへ集中しているなら、内部リンクやURL生成ルールの見直し候補です。
クロールされないときの確認順
対象URLが公開され200で応答するか、robots.txtで許可されているか、ログインなしで表示できるかを確認します。次に、既存ページからリンクがあるか、サイトマップへ正規URLが載っているかを見ます。
JavaScriptで表示する商品情報は、URL検査のレンダリング結果で確認します。ブラウザで見えることだけを根拠にせず、初期HTML、レンダリング後のHTML、リソース取得エラーを分けて調べます。
よくある間違い
- クロール回数が多いほど順位が上がると考える
- 商品登録だけで自動的に発見されると思う
- サイトマップだけに頼り内部リンクを用意しない
- 不要URLをcanonicalだけで無制限に生成し続ける
- エラー時もすべて200を返す
確認項目
- 主要商品がカテゴリからリンクされているか
- リンクに実際のhrefがあるか
- robots.txtで重要URLや必要リソースを塞いでいないか
- サイトマップに正規URLが載っているか
- 5xxや429が継続していないか
- 不要なパラメータURLへクロールが偏っていないか
新商品公開フローを点検する
商品公開時に、商品ページの生成、カテゴリ所属、内部リンク、サイトマップ更新が同じタイミングで行われるかを確認します。商品ページだけ先に公開され、カテゴリへの掲載が翌日になる仕組みでは、発見経路が一時的に弱くなります。
予約商品や公開日時を指定する商品では、公開前にサイトマップへ載る、公開後もnoindexが残るといったずれが起きやすくなります。公開前、公開時、公開後の状態をテストデータで再現し、URL、応答、リンク、robots設定を確認します。
クロールログの読み方
サーバーログには、アクセス日時、URL、User-Agent、ステータス、応答時間などが残ります。Googlebotを名乗る偽のアクセスもあり得るため、厳密な分析では公式の検証方法で確認します。
商品、カテゴリ、画像、パラメータ、404のようにURLを分類し、アクセス回数と最終クロール日を集計します。単に総リクエスト数が増えたかではなく、新商品へ届いているか、不要URLが大半を占めていないか、5xxの発生後にクロールが変化したかを見ます。
クロールを促す施策の限界
URL検査から登録をリクエストしたり、サイトマップを再送信したりしても、クロールやインデックスは保証されません。大量の商品URLを毎日手動申請する運用は続かず、根本原因も残ります。
重要ページへ通常リンクを用意し、重複URLを減らし、サーバーが安定して応答し、内容を正しく返す状態を優先します。発見経路と取得環境が整っていれば、個別申請は例外的な確認手段として使えます。
ECサイトでの調査例
新しいスニーカーモデルが検索に出ない場合、商品URLだけを調べず、所属カテゴリの「新着スニーカー」を開きます。商品カードにhrefがあるか、ページ送りの後半に埋もれていないか、カテゴリがnoindexではないかを確認します。
次に商品URLが200で応答し、robots.txtで許可され、サイトマップへ載っているかを見ます。ログにGooglebotの取得がなければ発見経路、取得後ならインデックス側の問題と切り分けられます。
同時に、同商品の色パラメータURLへ多数のクロールがないかを確認します。基本商品よりバリエーションURLへ偏っているなら、商品カードや選択リンクのURL生成を見直します。このように重要URLと周辺URLを一組で調べると、個別申請だけでは見えない原因を把握できます。
まとめ
Googleのクロールは、ページを発見して取得する過程です。ECサイトでは、通常リンク、XMLサイトマップ、安定したHTTP応答を通じて、重要な商品やカテゴリへ到達できる状態を作ります。
主要な商品URLを一つ選び、カテゴリからリンクをたどり、robots.txt、応答、URL検査、サイトマップを順に確認してください。クロールされない原因を技術設定と発見経路に分けると、必要な修正を絞り込めます。