SEO自動化でできること・人が判断すること|ECサイトの役割分担
目次
SEO自動化は、検索データの取得からサイト反映までをすべて無人にすることではありません。ECサイトでは商品事実、法的表現、ブランド方針、在庫など、人が責任を持って判断すべき情報があります。一方、データ収集、候補抽出、下書き、履歴保存のような反復作業は、自動化しやすい領域です。
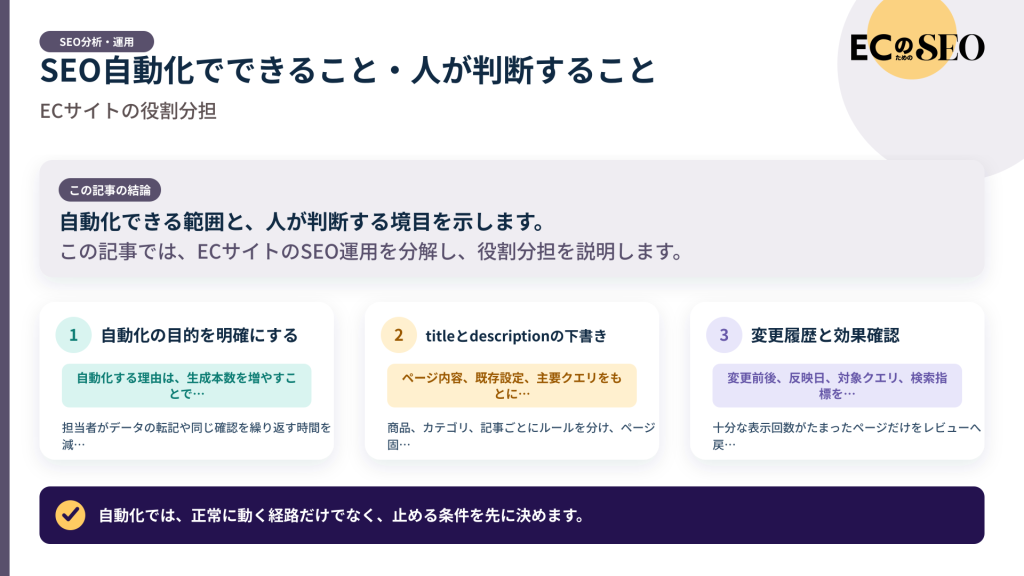
安全な自動化には、工程ごとに「機械が処理する」「人が承認する」「条件外なら止める」を分ける必要があります。この記事では、ECサイトのSEO運用を分解し、役割分担を説明します。
自動化の目的を明確にする
自動化する理由は、生成本数を増やすことではありません。担当者がデータの転記や同じ確認を繰り返す時間を減らし、商品事実、検索意図、事業優先度の判断へ集中することです。
導入前に、候補抽出、文章作成、CMS入力、効果確認のどこが詰まっているかを測ります。ボトルネックと違う工程を自動化しても、全体の時間は短くなりません。
検索データの取得は自動化しやすい
Search Consoleからクエリ、ページ、表示回数、クリック数、CTR、平均掲載順位を定期的に取得し、分析用データへまとめる作業は自動化できます。手作業のダウンロードと転記を減らせます。
ただし、プロパティ、期間、検索タイプ、集計単位を正しく設定する必要があります。匿名化クエリやデータ行の制限など、元データの性質は自動化しても変わりません。
技術的な除外判定
noindex、リダイレクト、404、canonical先が別、ログイン必須などを検出し、通常の改善候補から外す処理は自動化しやすい領域です。不要なURLを人が毎回確認する負担を減らせます。
判定不能、取得失敗、複数のcanonical候補などは、無理に進めず保留します。例外をエラーとして記録し、人が確認できるようにします。
改善候補の並べ替え
表示回数、順位帯、CTR、重複、未設定などの条件で候補を抽出し、確認順を付けられます。クエリとランディングページの組み合わせを基本にし、ページ全体の平均だけで決めないようにします。
スコアが高いページをそのまま自動変更せず、在庫、終売、戦略商品、検索意図を人が確認します。スコアはレビューの優先度です。
ページ情報の取得
対象ページから、現在のtitle、meta description、見出し、本文、商品情報を取得できます。既存設定とページ内容を一つの画面へまとめれば、確認時間を短縮できます。
JavaScriptで表示される内容、ログイン後の情報、バリエーション、在庫など、取得しにくい要素があります。取得できなかった情報を空欄のまま推測で補わず、人へ通知します。
titleとdescriptionの下書き
ページ内容、既存設定、主要クエリをもとに、titleとmeta descriptionの案を生成できます。商品、カテゴリ、記事ごとにルールを分け、ページ固有の文面を作ります。
AIは、存在しない仕様や不正確な表現を生成する可能性があります。商品名、型番、価格、在庫、実績、安全性を人が確認し、キーワードの羅列や誇張を避けます。
重複とルール違反の検査
生成案が他ページと重複していないか、禁止語、長すぎる共通文、空欄がないかを自動検査できます。ページ本文に存在しない語句を検出する補助も考えられます。
文字列が一致しないだけで品質が保証されるわけではありません。意味が同じ文章、検索意図のずれ、ブランドらしさは人が確認します。
承認フロー
低リスクページは編集担当、高リスク商品は商品・法務担当など、ページ種別と内容に応じて承認先を自動で振り分けられます。未承認の案は公開しない状態を保ちます。
誰が何を確認したかを記録します。「人が確認済み」という一つのチェックだけでなく、商品仕様、法務、検索意図の役割を分けます。
サイトへの反映
CMSのAPI、連携機能、タグ管理、JavaScriptなど、サイト環境に合う方法で反映を支援できます。手作業のコピーを減らし、承認済みの内容だけを対象にします。
一括反映前に少数ページでテストし、文字化け、欠落、テンプレート競合、意図しない上書きを確認します。反映失敗時は自動で次へ進まず、対象URLとエラーを記録します。
公開後の確認
公開ページでtitleとmeta descriptionが出力されているか、HTTP状態、noindex、canonicalが意図どおりかを自動確認できます。承認案と実際のHTMLが一致するかを比べます。
検索結果への反映はGoogleの再クロールと処理が必要です。サイトへ出力されたことと、検索結果で使われたことを分けて記録します。
変更履歴と効果確認
変更前後、反映日、対象クエリ、検索指標を保存し、次回確認日になったページを抽出できます。十分な表示回数がたまったページだけをレビューへ戻します。
数値が下がったら自動で元に戻すのではなく、季節、在庫、競合、Googleの更新を人が確認します。明確な誤反映は別の緊急復旧ルールで対応します。
人が判断すること
- 事業上どの商品・カテゴリを優先するか
- 検索意図とページの役割が合うか
- 商品事実と法的な表現が正しいか
- ブランドの言葉として適切か
- ページ本文や品ぞろえを改善できるか
- 数値変化を維持・再調整・復元のどれにするか
- 自動化ルールの例外を恒久化するか
段階的に自動化する
最初はデータ取得と候補抽出だけを自動化し、人が選定します。次に下書き、承認、反映、測定へ広げます。各段階で誤りの種類と確認時間を記録します。
全ページへ広げる前に、一カテゴリや一つのページ種別で試します。好調ページの保護、除外条件、停止方法を確認します。
自動化を止められる設計にする
自動化では、正常に動く経路だけでなく、止める条件を先に決めます。商品データが欠けている、現在のtitleを取得できない、承認者が不在、公開後の文字列が想定と違うといった場合は、自動で次へ進めず確認待ちへ送ります。
反映件数の上限や対象カテゴリを設定し、最初は少数ずつ公開します。誤ったテンプレートが全商品へ広がる前に検知できます。好調ページや法的表現を含むページを保護対象にすることも重要です。
担当者には、停止、再開、対象外、差し戻しの権限を必要な範囲で与えます。自動化の判断理由と処理結果が見えなければ、問題発生時に原因を追えません。速度だけでなく、確認可能性と復旧のしやすさを設計に含めます。
自動化前に入力データを整える
自動化の出力品質は、商品名、ブランド、カテゴリ、在庫状態、正規URLなどの入力データに左右されます。表記揺れや空欄があるままでは、確認や差し戻しが増えます。まず必須項目と参照元を決め、どのデータが最新かを明確にします。
商品説明に事実と販促コピーが混在している場合は、生成時に参照してよい項目を分けます。医薬品、健康、美容、金融など表現確認が必要な商材では、承認者と禁止表現を設定します。
入力データのエラーを文章生成で補おうとせず、元データの修正へ戻す経路を作ります。同じ誤りが複数ページで起きたとき、個別修正ではなく商品マスタや連携処理を直せるためです。
まとめ
SEO自動化では、データ取得、対象外判定、候補抽出、下書き、検査、反映、履歴、確認日の通知を仕組みにしやすい一方、商品事実、検索意図、ブランド、事業優先度、最終判断は人が担います。完全無人化ではなく、例外で止まり、承認を記録できる運用を作ることが、大量ページを安全に改善する土台になります。